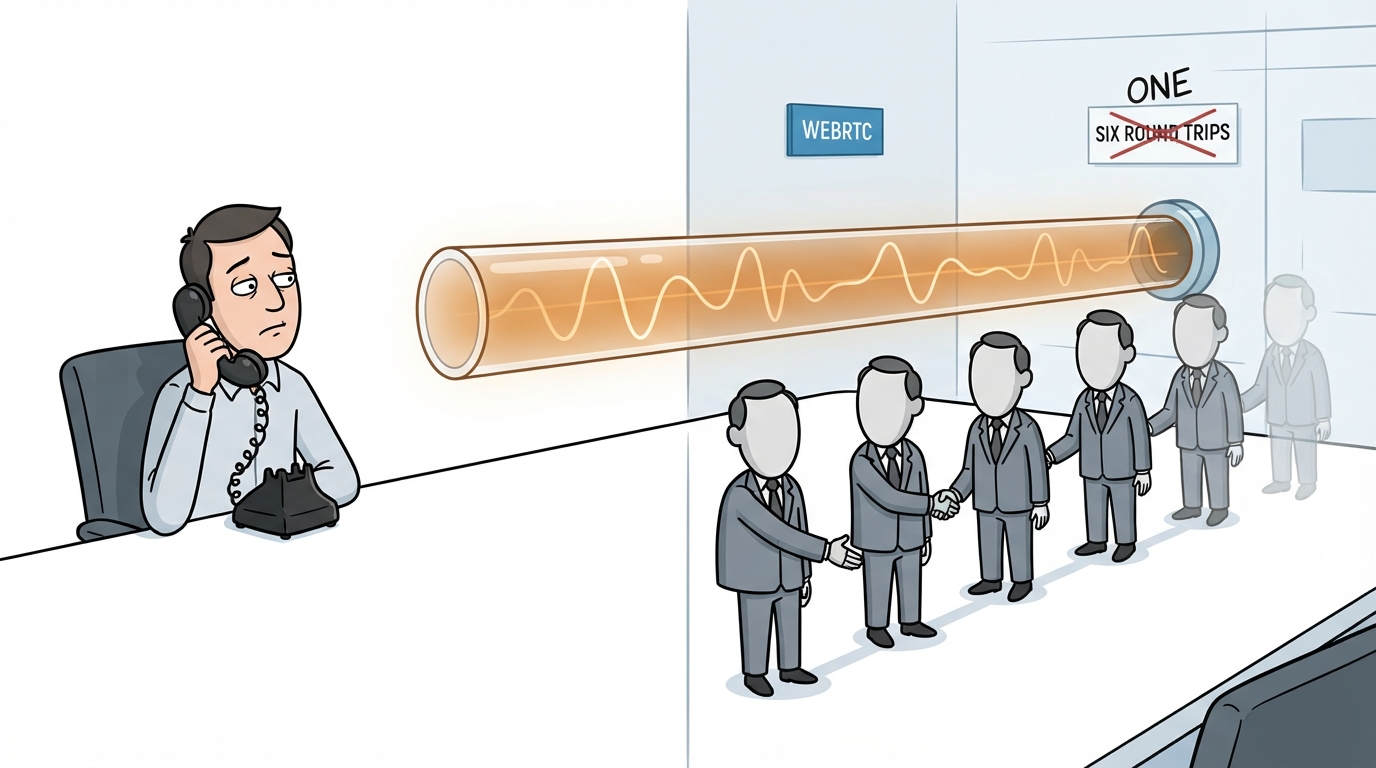
Шесть рукопожатий до голоса
Когда вы нажимаете кнопку голосового вызова в ChatGPT, начинается то, что инженеры OpenAI называют startup sequence. До GPT-Live это означало шесть сетевых рукопожатий: ICE, DTLS, SCTP, DCEP, сигнализация, плюс ожидание ответа сервера. Шесть round-trip. Шесть маленьких пауз, которые никто по отдельности не замечает, но вместе они складываются в то самое ощущение «ну давай, начинай уже».
Теперь — одно.
OpenAI опубликовала инженерный пост о GPT-Live, своей третьей голосовой системе. Название звучит как название операционки, но это про другое: про то, как заставить ИИ говорить и слушать одновременно, а не ждать очереди.
Что произошло
GPT-Live — full-duplex voice model. Она слушает и говорит в одно и то же время. Нет turn detector — крошечной модели-посредника, которая раньше гадала: пользователь закончил или просто задумался? Угадал рано — обрезал. Угадал поздно — заставил ждать.
Вместо этого голосовая модель держит непрерывный медиа-цикл: аудио течёт туда-сюда без разрывов. Когда нужен серьёзный ответ — reasoning или работа с инструментами — система асинхронно делегирует запрос к GPT-5.5. Пока тот думает, голосовая модель поддерживает разговор.
Три изменения в одном пакете: модель, инфраструктура и транспорт.
Протокол, у которого даже имя есть
OpenAI проанализировала стек WebRTC и обнаружила, что каждый протокол в нём содержит собственный механизм anti-DoS — даже когда в контексте полного стека он не нужен. DTLS, SCTP, ICE — каждый делал свою проверку, каждый добавлял задержку.
Результат — WARP, WebRTC Abridged Roundtrip Protocol. Обратная совместимость сохранена, но handshake сокращён с шести round-trip до одного:
- DTLS 1.3 handshake вместо более медленного предшественника
- SCTP handshake предсогласован (SNAP)
- data channels предсогласованы без DCEP
- DTLS-рукопожатие «оседлало» ICE (SPED)
WARP — набор открытых спецификаций. OpenAI работает с сообществом WebRTC через IETF TSVWG. Поддержка уже добавлена в libwebrtc и Pion.
Отдельно — Instant Connect. Параметры SDP согласовываются заранее, без резервирования серверных ресурсов. Если параметры валидны — сервер материализует сессию по первому UDP-пакету. Если нет — клиент незаметно откатывается на стандартный сигнальный поток. Без дополнительной задержки.
Go вместо Python
Медиа-фронтенд и логика вывода переписаны на Go. Предыдущая реализация использовала Python asyncio. Результат: p95 нового по задержке равен p50 старого. То есть даже «медленные» запросы новой системы работают так же, как «средние» старой.
Это не косметика. В realtime-системе каждая миллисекунда в p95 — это то, что слышит пользователь.
Контекст, который не рвётся
Длинный голосовой вызов растёт в размере. Когда контекст превышает лимит модели, его нужно компактифицировать. Обычная компактификация инвалидирует KV-cache, требует нового префилла и создаёт задержку.
OpenAI обрабатывает это как управляемый переход: пока оригинальная инстанция модели продолжает разговор, система компактирует контекст, подготавливает замену и переключается без прерывания медиа. То же самое при миграции между инстанциями модели — warm-запуск параллельно, префилл, cut-over.
Shadow-тестирование на реальных пользователях
Перед запуском OpenAI провела silent test: часть сессий ChatGPT Voice маршрутизировалась параллельно — и в старую Advanced Voice Mode, и в GPT-Live в read-only режиме. Пользователи старой системы не замечали разницы.
Выяснилось три вещи:
Ёмкость — это не только GPU. Голосовые сессии держат соединение и шлют фреймы непрерывно. CPU-side stream handlers, очереди, сетевые пути — всё это масштабируется вместе с инференсом. Один вспомогательный компонент насытился раньше, чем предсказывали нагрузочные тесты.
География стала фактором первого порядка. Маршрутизация сессии в далёкий дата-центр добавляет задержку в нескольких точках. OpenAI начала валидировать модельные rollout вместе с региональной ёмкостью.
Проблемы длинных сессий не ловятся короткими тестами. Memory pressure, reconnects, race conditions в shutdown handshake — всё это проявляется только при реалистичных жизненных циклах.
Что это значит
GPT-Live — не просто «стало быстрее». Это архитектурный сдвиг от turn-based voice к continuous media loop. Голосовая модель больше не ждёт очереди. Она держит линию, а тяжёлую работу скидывает асинхронно.
API GPT-Live ещё не вышел, но архитектура уже становится платформой для realtime-взаимодействия — не только голос, но и агентная координация через десктопное приложение ChatGPT.
Человеческий разговор работает именно так: мы слушаем и говорим одновременно, а когда не знаем ответа — берём паузу, но не вешаем трубку. OpenAI наконец сделала то же самое.
Краткий ответ
OpenAI выпустила GPT-Live — third-generation voice system с full-duplex моделью. Turn detector удалён из аудио-пути: модель слушает и говорит одновременно. Протокол WARP сокращает WebRTC handshake с 6 до 1 round-trip. Асинхронная делегация к GPT-5.5 позволяет модели «думать», не прерывая разговор. Система проходит shadow-тестирование на реальном трафике ChatGPT Voice.