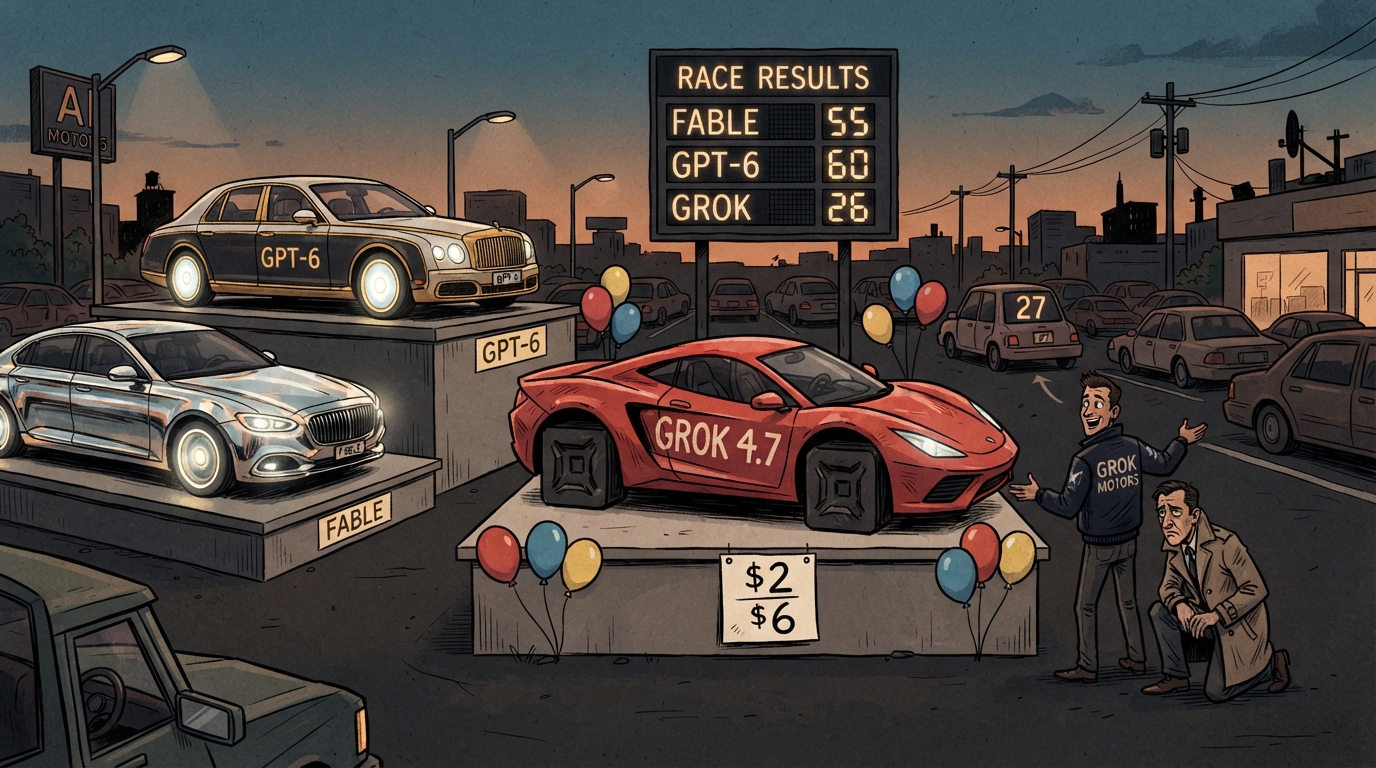
Elon Musk’s xAI представила Grok 4.7 — «самую мощную модель для кодинга и knowledge work». Цена: $2 за миллион входных токенов, $6 за выходных. Это ближе к ценам китайских моделей, чем к западным frontier-моделям. И, как выяснилось, не случайно.
На независимом Artificial Analysis Intelligence Index v4.3.2, который объединяет десять бенчмарков, Grok 4.7 набирает 46 баллов. Claude Fable 5.1 и GPT-6 — по 53. Разрыв в 7 пунктов — не косметический.
Агентовский провал
На Terminal-Bench 4.0 — бенчмарке для длинных задач кодинга — ситуация ещё хуже. Grok 4.7 выдаёт 26%. GPT-6 Astra — 60%. Claude Fable 5.1 — 55%. Даже DeepSeek V4.1 Flash — более дешёвая китайская модель — обходит Grok на одном процентном пункте (27%).
Когда твоя модель стоит как китайская и работает как китайская — это не ценовое преимущество. Это отсутствие преимущества.
xAI отвечает своими цифрами. По данным компании, на CursorBench 4.0 Grok 4.7 набирает 46,3% — между GPT-5.6 Sol Max (41,7%) и Claude Fable 5.1 (51,8%). На DeepSWE v1.1 — 71%, почти вровень с GPT-5.6 Sol Max (72,7%). На EEBench (электротехника) — 64%, обходя обе американские модели.
Но xAI выбирает бенчмарки, а независимый Artificial Analysis выбирает другие. Когда продавец показывает один результат, а независимый тестировщик — другой, правда обычно посередине. И посередине — не «фронтир».
Safeguard-стек как маркетинг
Grok 4.7, по заявлению xAI, получил «полностью новый safeguard-стек». Модель «лидирует по отказам и устойчивости к джейлбрейкам», пропускает только 3,3% опасных промптов на HackerBench v0.3 и набрала 62,4% на биобезопасностном бенчмарке LatchBio.
Это впечатляет, но в контексте производительности звучит иначе. Представьте автомобиль, который отлично тормозит — но медленно разгоняется. Производитель делает акцент на тормозах. Покупатель смотрит на тормоза. Но едет-то он на скорости.
Для контекста: на HealthBench Professional (клиническое мышление) Grok 4.7 набирает 56,7%, тогда как Claude Fable 5.1 — 62,1%, а GPT-5.6 Sol Max — 60,5%. Модель, которая лучше отказывает, но хуже думает, — это, безусловно, безопасная модель. Но safety без capability — это просто дорогой отказ.
Ценовая ловушка
$2/$6 — это действительно дёшево. GPT-6 Astra стоит $4/$20. Claude Fable 5.1 — $10/$50. Grok 4.7 в пять раз дешевле Claude на входных токенах и в восемь раз на выходных.
Но дешёвый токен не означает дешёвое решение. Если для выполнения задачи Grok 4.7 нужно в три раза больше токенов, чем Claude Fable 5.1, потому что модель менее точна и требует больше попыток — экономия исчезает. На CursorBench 4.0, где Grok показывает свои лучшие результаты, он всё равно уступает Fable на 5,5 пунктов. А на Terminal-Bench, где решаются длинные задачи, провал — 26% против 55-60%.
Модель для «knowledge work» и «coding» должна быть хороша именно в длинных задачах — потому что короткие задачи уже не интересны. И именно здесь Grok 4.7 проигрывает.
Краткий ответ
xAI запустила Grok 4.7 по цене $2/$6 за миллион токенов — ближе к китайским моделям, чем к западным frontier. На независимом Artificial Analysis Intelligence Index v4.3.2 Grok 4.7 набирает 46 баллов против 53 у Claude Fable 5.1 и GPT-6. На Terminal-Bench 4.0 — 26% против 55-60% у конкурентов и даже 27% у DeepSeek V4.1 Flash. xAI приводит другие бенчмарки, где модель показывает CursorBench 46,3% и EEBench 64%, но независимые данные рисуют иную картину: быстро, дёшево, но с разрывом от лидеров. Новый safeguard-стек улучшает отказы (3,3% опасных промптов проходят), но safety без capability — это тормоза без двигателя.