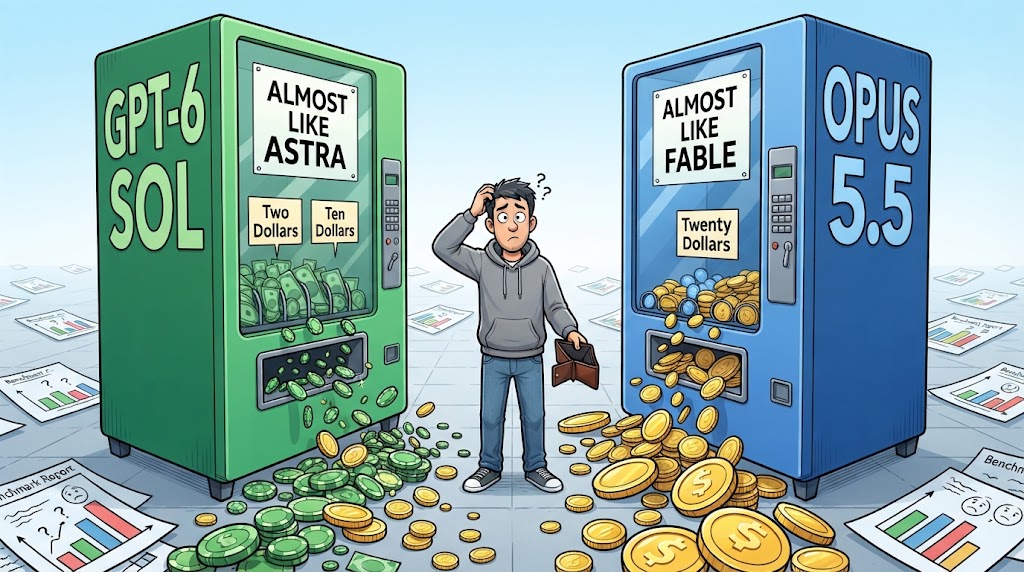
Второе сентября, оба лагеря
Двадцать второго сентября OpenAI и Anthropic выпустили обновления почти одновременно. Совпадение? Возможно. Но когда обе компании в один день снижают цены на 40–50% и обещают «производительность флагмана за цену середняка», это пахнет не совпадением, а ценовой войной, которая длится с начала года.
OpenAI представила GPT-6 Sol и GPT-6 Luna. Цены снижены вдвое по сравнению с GPT-5.6: Sol — $2/$10 за миллион токенов, Luna — $0.10/$0.50. Anthropic ответила Claude Opus 5.5: output-токены $20 за миллион (было $25 у Opus 5), общая стоимость эксплуатации снижена на 40%.
Обе компании заявили, что новые модели достигают уровня их же флагманов. OpenAI — что Sol сравним с Astra. Anthropic — что Opus 5.5 на уровне Fable 5.1.
Бенчмарки говорят разное
Проблема — в том, какие именно бенчмарки.
По данным OpenAI, GPT-6 Sol на AutomationBench стоит 9% от стоимости Claude Opus 5 при сопоставимом результате. На FrontierCode 1.1 Sol за $2.14 достигает 49.3% — почти как Fable 5.1 за $12.83. На DeepSWE v1.1 Sol отстаёт от Fable 5 всего на 1.1 процентных пункта при стоимости в пять раз ниже.
Anthropic отвечает иначе. По её бенчмаркам, Opus 5.5 обходит GPT-6 Astra на большинстве задач. Один из тестировщиков завершил миграцию кодовой базы на 680 000 строк менее чем за день. На задаче ускорения загрузки веб-приложения Opus 5.5 преуспел 39 раз из 40, тогда как Opus 5 делал меньшие улучшения, менявшие поведение приложения.
The Decoder резюмирует прямо: «едва двигает иглу» (barely moves the needle). Редакция отмечает, что бенчмарки с обеих сторон выглядят cherry-picked — каждая компания выбирает те задачи, где её модель выглядит лучше.
Уровни reasoning: кто в этом разберётся?
Самая ироничная деталь дня — в ценовой структуре GPT-6. Luna на «max effort» равна Sol на «xhigh» при цене на 78% ниже. Sol на «max effort» лишь на 2.2 процентных пункта выше Luna. Редакция The Decoder задаёт вопрос, который повисает в воздухе: «кто должен разбираться во всех этих уровнях reasoning в реальном применении?»
Действительно: xhigh, max, medium, low — это четыре уровня, которые разработчик должен выбрать для каждого запроса, не зная заранее, насколько сложной окажется задача. Оптимистичная стоимость одного запроса может вырасти в десять раз, если модель «решит», что нужен max effort.
Зачем всё это
Ценовое давление началось с китайских моделей. Qwen, GLM и DeepSeek дали производительность на уровне GPT-4 за долю цены — и заставили американские лаборатории реагировать. Anthropic и OpenAI не могут конкурировать с китайскими ценами напрямую — их инфраструктура дороже, регуляторные расходы выше, требования к безопасности жёстче. Но они могут снижать цены на свои «средние» модели, приближая их к флагманам.
Результат парадоксален: флагманские модели обеих компаний теперь не нужны для большинства задач. Sol и Opus 5.5 достаточно хороши — и в несколько раз дешевле. Astra и Mythos остаются для тех, кому нужен абсолютный потолок, но таких пользователей немного.
Краткий ответ
В один день OpenAI и Anthropic выпустили модели, которые, по заявлениям компаний, достигают уровня их флагманов при сниженной цене на 40–50%. Независимые бенчмарки показывают более скромный прогресс: «едва двигает иглу». Обе компании cherry-pick задачи, где их модели выглядят лучше. Главная ирония: флагманские модели обеих компаний стали практически ненужны для большинства задач.