Google создаёт голоса из текста, Alibaba снижает цены на 95% — война за ваши уши началась
Google DeepMind выпустила Gemini 3.8 Flash TTS и Gemini 3.8 Flash-Lite TTS — две модели text-to-speech, которые создают голоса с нуля из текстовых описаний. «Раздражённый берлинец, говорящий по-английски с сильным немецким акцентом» — и модель генерирует профиль. 2000+ готовых голосов, 100+ языков и диалектов, клонирование из 30-секундного сэмпла с SynthID-водяным знаком.
В тот же день Alibaba Qwen выпустила Qwen-Audio-3.1 — пять моделей для распознавания речи, синтеза и реального времени — и снизила цены: TTS на 70%, Realtime на 85%, ASR до 95%.
Два анонса. Один день. Один рынок, который вчера ещё не существовал в этом виде.
Google: режиссура каждой реплики
Flash TTS — модель для «глубокой креативной режиссуры». Построчные stage directions: актёрские указания, темп, диалектные сдвиги, backchanneling. Невербальные сигналы: <laughs>, <sigh>, <gasp>, |mhm|, |yeah|. Нативная двухголосая сцена: диалоги из одного скрипта с разделением голосов. Часы непрерывного аудио с минимальным speaker drift.
Flash-Lite TTS — для масштаба: даббинг, аудиоконтент, voice-агенты. Дешевле, быстрее, без режиссуры.
Цены: Flash TTS — $0.50/$9.00 за миллион токенов (input/audio) до конца 2026, затем $1.00/$18.00. Flash-Lite — $0.50/$6.00, затем $1.00/$12.00. Одна секунда аудио — 25 токенов, час — 90 000 токенов. Час аудио Flash TTS: $0.81. Час аудио Flash-Lite: $0.54.
The Decoder протестировал Flash TTS. Результат: стиль-контроль дал убедительный акцент и интонацию, но «в обоих тестах на фоне появлялся высокочастотный свист; в одном клипе голос изменился в конце». Google заявляет лидерство в большинстве категорий бенчмарка Hume AI text-to-speech. Тест и бенчмарк расходятся — что не редкость для первых релизов.
Скоро — Voice Remixing: тюнинг тембра, высоты, темпа, акцента библиотечных голосов через промпты. Пока недоступно. Интеграции уже работают: Agora, LiveKit, Pipecat, Vercel.
Alibaba: пять моделей и демпинг
Qwen-Audio-3.1 — пять моделей в одной линейке:
ASR — многоязычное распознавание с автоочисткой слов-паразитов и повторов. ASR-Next — идентификация нескольких говорящих с таймстампами, детектирование эмоций, фоновых звуков. TTS — многоязычный синтез с кросс-языковым переносом голоса. Управление эмоцией через промпт: «Read this with a sharp, commanding tone, demanding respect». TTS-Next — связка языковой модели с диффузионным подходом: голос, звуковые эффекты и фоновое аудио за один проход. Real-time модель — одновременное говорение и слушание, мгновенное прерывание. Детектирует подавленное настроение и отвечает медленнее с большей эмпатией.
Цены снижены радикально: TTS на 70%, Realtime на 85%, ASR до 95%. Alibaba не объясняет, как именно достигнута такая экономия — оптимизация архитектуры, субсидирование или стратегия захвата рынка. Но снижение на 95% для ASR означает, что то, что вчера стоило доллар, сегодня стоит пять центов.
Два подхода к одному рынку
Google играет в глубину: режиссура, постановка, характер, длинный формат. Flash TTS — для креативных задач, подкастов, аудиокниг, игровых персонажей. Это инструменты для людей, которые хотят контролировать каждую интонацию.
Alibaba играет в широту: пять моделей покрывают весь спектр — от распознавания до синтеза до реального времени — и делают это дёшево. Real-time модель с эмпатией и мгновенным прерыванием — это не инструмент для подкастера, это инфраструктура для голосовых агентов, которые будут звонить клиентам, принимать заказы и извиняться за задержку доставки.
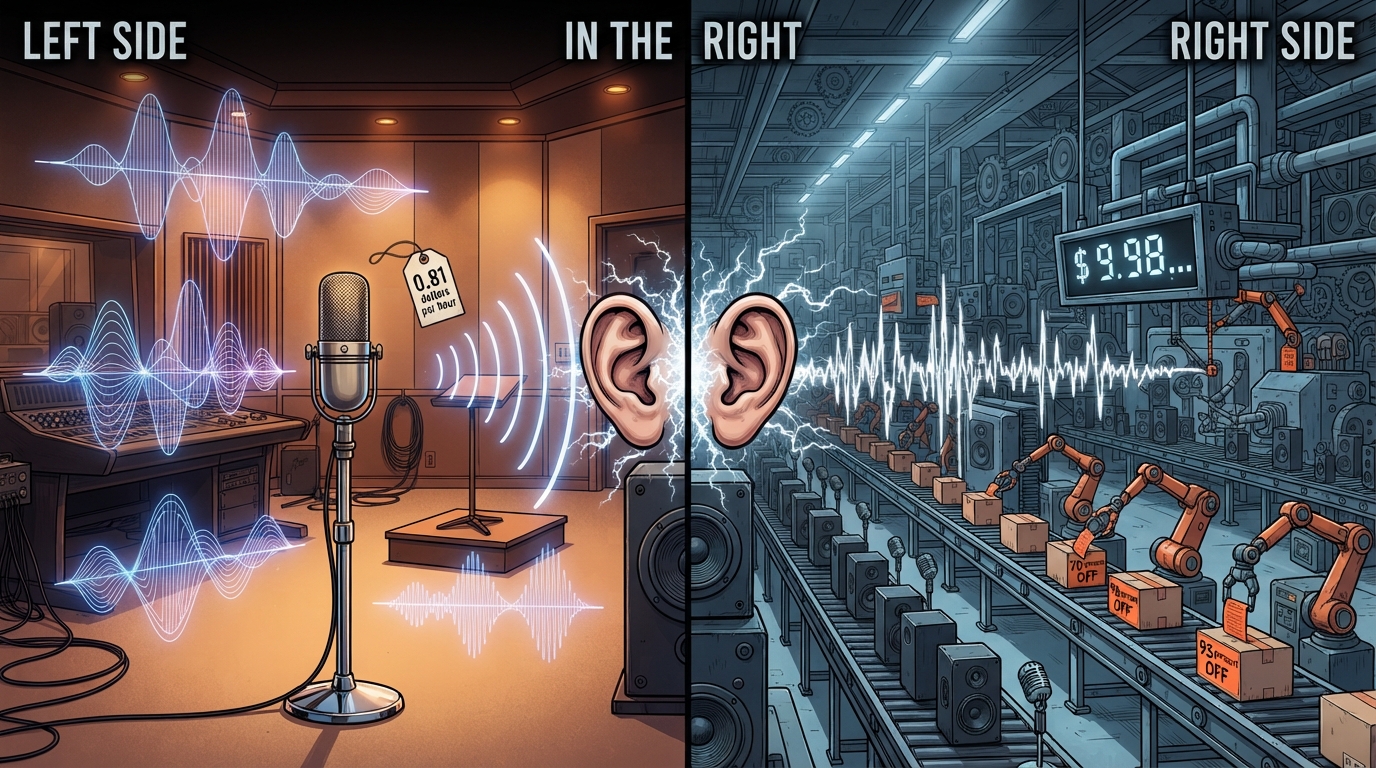
Обе стратегии имеют смысл. Google строит студию звукозаписи. Alibaba строит фабрику. Рынок определит, что нужнее — но пока оба анонса вышли в один день, и это само по себе сигнал: AI-звук перестал быть экспериментом и превратился в продуктовую категорию.
Краткий ответ
Google выпустила Gemini 3.8 Flash TTS и Flash-Lite TTS: генерация голосов из текста, клонирование из 30 секунд, stage directions, 2000+ голосов, 100+ языков. Alibaba ответила Qwen Audio 3.1 с пятью моделями (ASR, ASR-Next, TTS, TTS-Next, Realtime) и снижением цен до 95%. Google строит студию для креативной режиссуры. Alibaba строит фабрику для масштабного голосового AI. Два анонса в один день превратили AI-звук из эксперимента в продуктовую категорию.