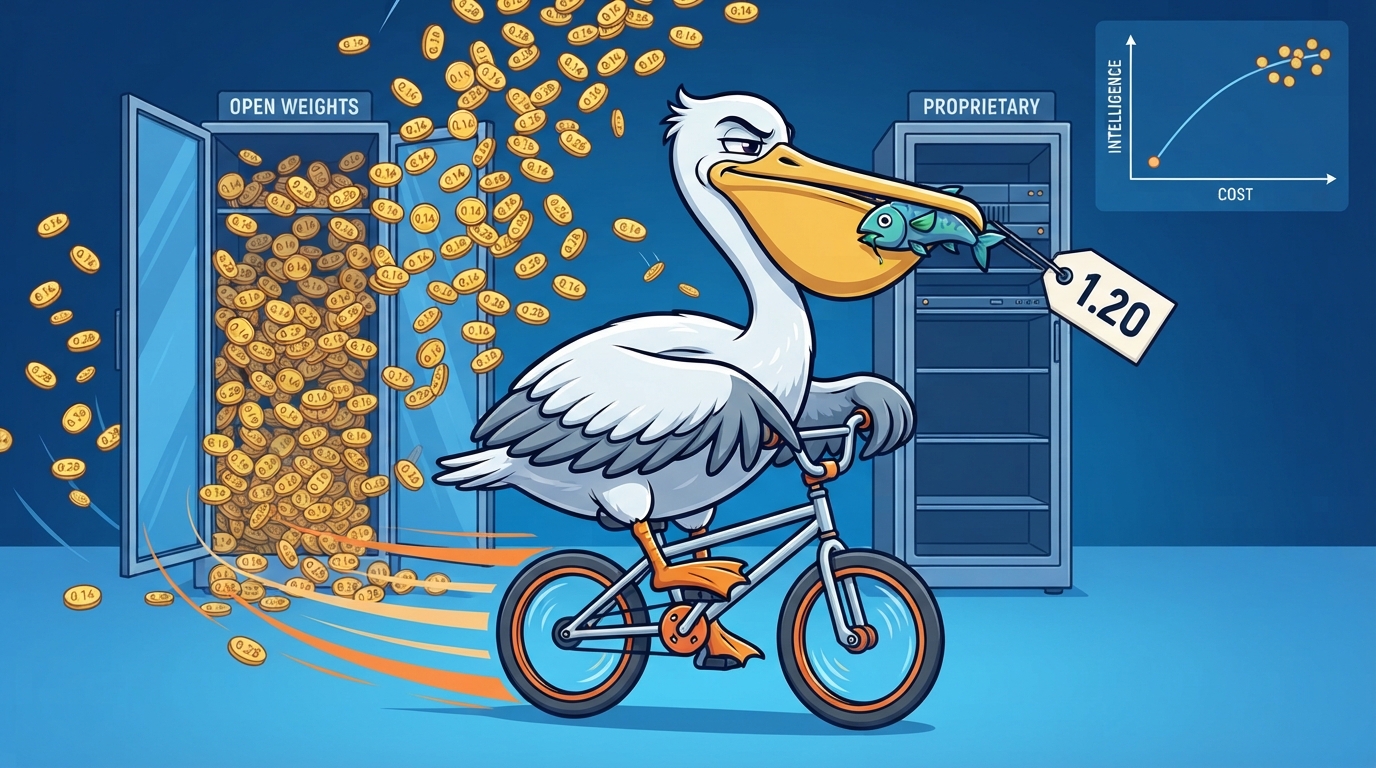
DeepSeek обновил V4-Flash — и сделал это тихо, без фанфар и презентаций на сцене в чёрной водолазке. 304 миллиарда параметров, 13 миллиардов активных на токен, MIT-лицензия, цена — $0,14 за миллион входных токенов. Это примерно треть от output-цены V4-Pro и в десять раз дешевле конкурентов с сопоставимым intelligence.
Что изменилось (спойлер: не архитектура)
Архитектура не изменилась. Это тот же MoE на 284B параметров с 13B активных на токен, контекстным окном в миллион токенов, 256 routed experts и hash routing на первых трёх слоях. Прирост — результат re-post-training, а не нового дизайна. Чекпойнт поставляется с модулем спекулятивного декодинга DSpark.
На стороне API модель теперь нативно поддерживает Responses API и адаптирована под Codex. V4-Pro и пользовательские модели не обновлялись.
Бенчмарки: бьёт модель, которая в полтора раза больше
Artificial Analysis ранжирует V4 Flash 0731 выше MiniMax M3 — модели с 428 миллиардами параметров. На графике Intelligence Index vs Cost per Intelligence Task он сидит в одиночку на дальнем левом краю: ~$0,028 за задачу при intelligence score 50. Модели с похожим или более низким intelligence — MiniMax-M3, Kimi K3 (low), GLM-5.1, Kimi K2.6 — стоят в десять раз дороже.
Пеликан на велосипеде: тест Саймона Уиллисона
Саймон Уиллисон проверил модель на своём стандартном тесте pelican-bicycle — векторная иллюстрация пеликана на велосипеде. На дефолтном reasoning level через OpenRouter — разочаровывающий результат: велосипед без спиц, рама разваливается.
На high reasoning effort — совсем другое дело: пеликан держит руль крыльями, одна оранжевая лапа на педали, в клюве маленькая голубая рыбка. Рама красная/синяя/оранжевая, speed lines сзади для передачи движения.
llm -m openrouter/deepseek/deepseek-v4-flash-0731 -t pelican -o reasoning_effort highМораль: модель умеет больше, чем показывает на дефолте. Нужно только попросить подороже.
Два способа развернуть
Через API — доступно почти всем: $0,14 за 1M input на cache miss, $0,0028 на cache hit, $0,28 за 1M output, лимит конкурентности 2 500. Стартапы на посевной стадии и инди-разработчики могут гонять агентные циклы без GPU-бюджета.
Через self-hosting — планка выше: веса MIT-лицензированы и ungated, но все эксперты резидентны в памяти. Пример DeepSeek на vLLM — один узел 4×GB300. Dynamic GGUFs от Unsloth дают lossless 8-битный билд 162 GB и 3-битный 103 GB — примерно 110 GB RAM плюс VRAM.
Контекст: ценовая война, которую все хотели
DeepSeek продолжает делать то, что делает лучше всего: ставить под вопрос ценообразование западных лабораторий. V4-Flash за $0,14 на вход — это не демпинг. Это заявление о том, что intelligence per dollar — единственная метрика, которая имеет значение для разработчиков, оплачивающих API из своего кармана.
OpenAI отвечает GPT-5.6 Luna по $0,20/$1,20. Google держит Gemini 3.6 Flash в своём орбитальном ценообразовании. А DeepSeek просто выкладывает MIT-модель, которая на графике Artificial Analysis сидит в одиночку в левом нижнем углу — там, где дёшево и умно.
Часто задаваемые вопросы
Что такое DeepSeek V4 Flash 0731?
Обновление модели V4-Flash через re-post-training. Та же архитектура 284B MoE с 13B активных параметров, но с улучшенными агентными и кодинговыми возможностями.
Сколько стоит DeepSeek V4 Flash 0731?
$0,14 за 1M входных токенов на cache miss, $0,0028 на cache hit, $0,28 за 1M выходных токенов. Лимит конкурентности 2 500.
Можно ли использовать DeepSeek V4 Flash 0731 коммерчески?
Да. MIT-лицензия позволяет скачивать, запускать локально, модифицировать и использовать коммерчески без лицензионных отчислений.
Что такое пеликан на велосипеде?
Стандартный тест Саймона Уиллисона для проверки способностей модели к генерации изображений. На high reasoning effort V4 Flash 0731 нарисовал пеликана, держащего руль крыльями, с рыбкой в клюве.
Краткий ответ
DeepSeek выпустил V4-Flash-0731 — обновление через re-post-training той же 284B MoE-архитектуры. Модель бьёт 428B MiniMax M3 по соотношению intelligence/cost, стоит $0,14/$0,28 за 1M токенов через API и доступна под MIT-лицензией для self-hosting.