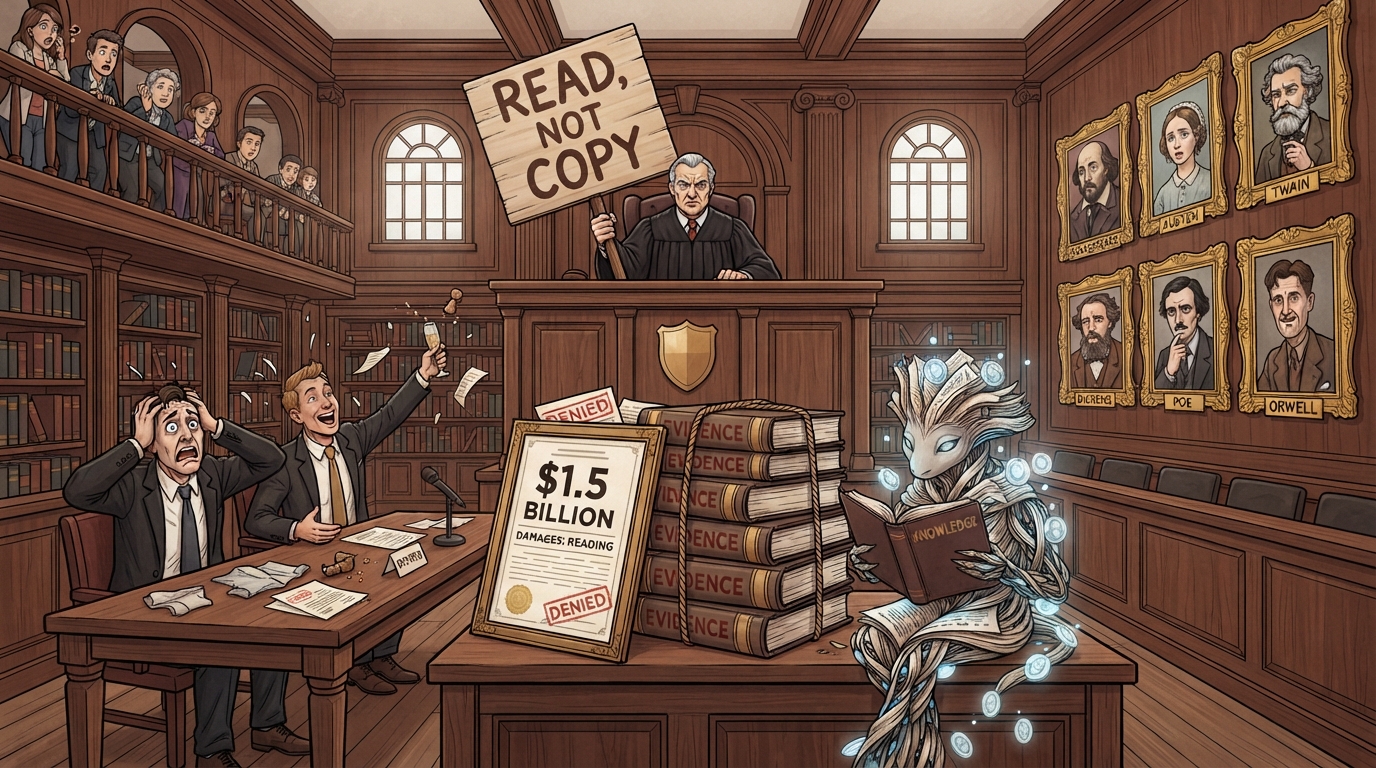
Миллиард с половиной долларов за привычку читать
Anthropic заплатила $1.5 млрд за то, что, по сути, сходила в библиотеку. Правда, библиотека оказалась пиратской, и судья Уильям Алсуп это отдельно отметил — но в том же решении написал, что сам процесс обучения AI на текстах является законным актом чтения.
Читайте это ещё раз, если у вас не укладывается: компания, которая прогнозирует выручку в $200 млрд к 2028 году, отдала полтора миллиарда, и при этом её юристы открывают шампанское.
Адвокат по интеллектуальной собственности Кэти Геллис объяснила TechCrunch, почему: «Закон об авторском праве hinges on copying, but it doesn’t hinge on using the work or experiencing the work, consuming the work, reading the work.» Перевод: нельзя штрафовать за чтение. Можно — за скачивание чтения из подпольного репозитория. Именно это Anthropic и сделала.
Судья сказал: «Как писатель»
Самая любопытная часть решения — аналогия Алсупа. Он сравнил прогон триллионов токенов через языковую модель с тем, как писатель изучает литературу перед тем, как сесть за собственный роман. «Anthropic’s LLMs trained upon works not to race ahead and replicate or supplant them — but to turn a hard corner and create something different» — написано в постановлении.
Геллис считает, что это «generally good news for AI training». Если суд рассматривает обучение модели как чтение, а не как копирование, то весь фундаментальный механизм работы LLM получает судебную индульгенцию. Остались бы детали — вроде того, откуда именно взяты книги.
Геллис добавляет: «What’s a $1.5 billion fine to a company projecting about $200 billion in annual revenue by 2028?» Это не наказание. Это плата за вход.
Закон 1976 года против реальности 2026-го
Американский закон об авторском праве не обновлялся с 1976 года. Это значит, что судьи прямо сейчас пытаются применять правила, написанные во времена печатных машинок, к системам, которые обрабатывают сотни миллионов книг за одну тренировочную сессию.
Адвокат Джейсон Хендерсон из JWL International описал ситуацию прямо: «Everybody is very worried right now because the law is all over the place.» Он прав. Прецеденты создаются в реальном времени, и каждый новый суд может перевернуть предыдущий.
Тест на fair use — центральное оружие обеих сторон. Судьи оценивают, является ли использование «трансформативным»: изменило ли оно исходный материал достаточно, чтобы считать новым произведением? Тут всё зависит от того, как задать вопрос.
Конкуренция — это не fair use
Есть прецедент, который показывает границы допустимого. Thomson Reuters засудила Ross Intelligence за то, что та скопировала юридические материалы Reuters для создания конкурирующей AI-платформы. Судья Стефанос Бибас решил: это не fair use, потому что «Ross’s use is not transformative because it does not have a ‘further purpose or different character’ than Thomson Reuters’s.»
Коротко: если ты тренируешь AI, чтобы сделать продукт, который напрямую конкурирует с тем, чьи данные ты используешь, суд на тебя посмотрит косо. Если же ты делаешь чат-бота, который генерирует синтетические книги, — это пока не считается прямой конкуренцией авторам. Хотя авторы будут спорить.
Два разных вопроса, которые все путают
Геллис обращает внимание на важный нюанс: обучение AI на copyrighted материалах и авторское право на AI-генерированный контент — это разные юридические вопросы. В деле Thaler v. Perlmutter суд постановил, что на 100% AI-генерированную работу авторское право не распространяется.
«If you write your novel in Word and run spell check, we kind of feel comfortable with the idea of saying that Word does not own your novel» — Геллис показывает, как старые интуитивные представления ломаются, когда речь заходит о системах, которые не просто проверяют орфографию, а генерируют целые абзацы.
Что дальше
Все крупные AI-компании находятся в процессе судебных разбирательств по авторскому праву. Ни одно из них не будет завершено быстро. Первые решения формируют ландшафт, но каждый следующий суд может всё изменить.
«It would be kind of foolish for the AI companies to ignore them» — говорит Геллис. Вероятно, они не игнорируют. Просто полтора миллиарда для компании с $200 млрд в перспективе — это не остановка. Это цена билета.
Краткий ответ
Anthropic заплатила $1.5 млрд за использование пиратских библиотек, но судья Уильям Алсуп признал обучение LLM на copyrighted текстах законным актом чтения, а не копирования. Это создаёт прецедент, выгодный AI-индустрии: если модель «читает», а не «копирует», весь механизм обучения остаётся в рамках закона. Однако конкуренция на основе тех же данных fair use не является — Thomson Reuters против Ross Intelligence это подтверждает. Окончательных ответов нет: закон 1976 года ещё не адаптирован к реальности, где модель обрабатывает сотни миллионов книг за одну тренировку.